每日 X 精华引用榜

每天精选网络上最有价值的推文引用链,按“精华分”排行——引用即精华。

生成于 2026年7月30日 06:28
1
138.1万
精华分
6 层引用链锐评超原推

在ARC口水战中硬核回击:Anthropic没义务给OpenAI调试评测配置

Teortaxes▶️ (DeepSeek 推特🐋铁粉 2023 – ∞)
@teortaxesTex
@steipete 他们没有责任确保 OpenAI 得到良好的测试
Jul 30, 2026, 12:34 AM·34.6K Views
Peter Steinberger 🦞
Peter Steinberger 🦞
@steipete
哈哈,在发布“胜利”推文之前,Anthropic 没有人停下来想知道为什么这些数字看起来如此荒谬? https://openai.com/index/how-two-settings-tripled-our-arc-agi-3-scores/
Jul 30, 2026, 12:00 AM·990.6K Views
Claude
Claude
@claudeai
在 ARC-AGI-3(人工智能模型必须解决新问题的评估)中,Opus 5 的得分是次优模型的三倍。
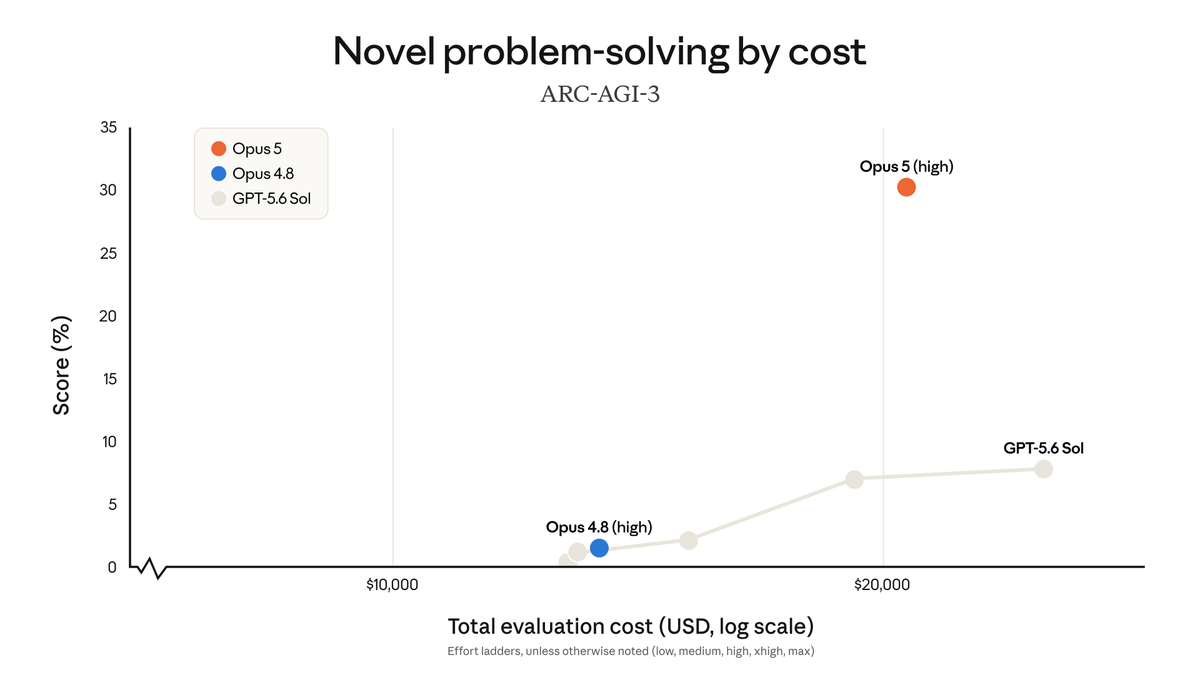
Jul 24, 2026, 04:59 PM·2.4M Views
Claude
Claude
@claudeai
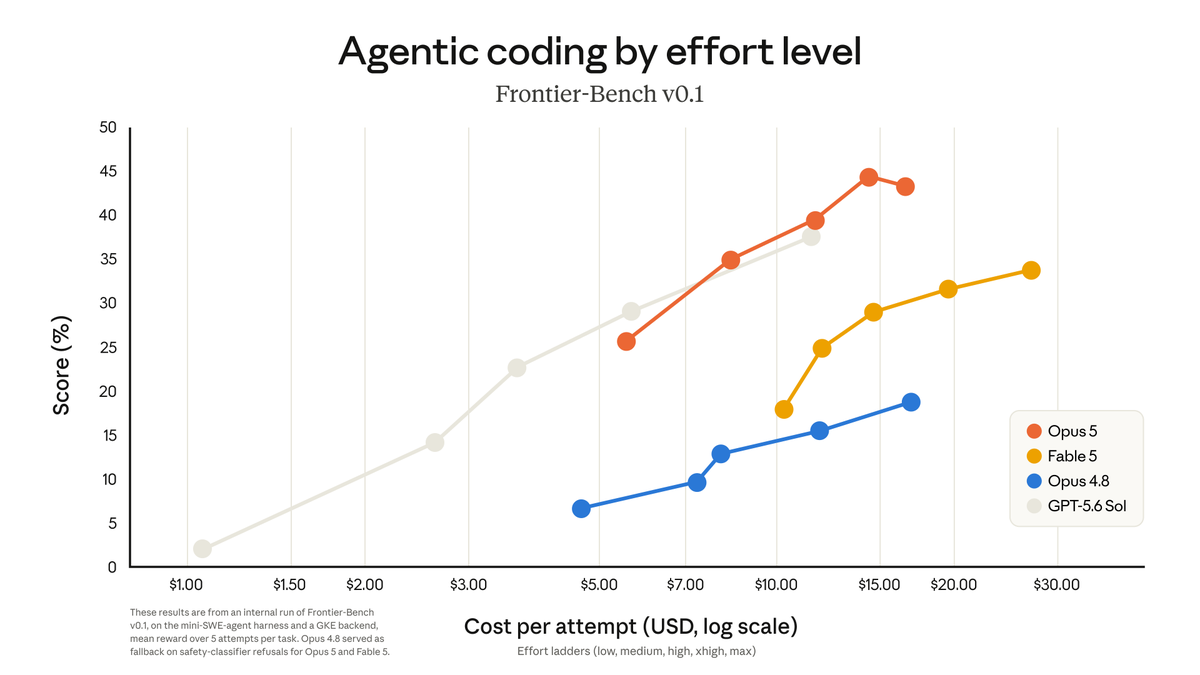
Opus 5 也非常高效。它在每项任务成本相似或更低的情况下优于其他模型:
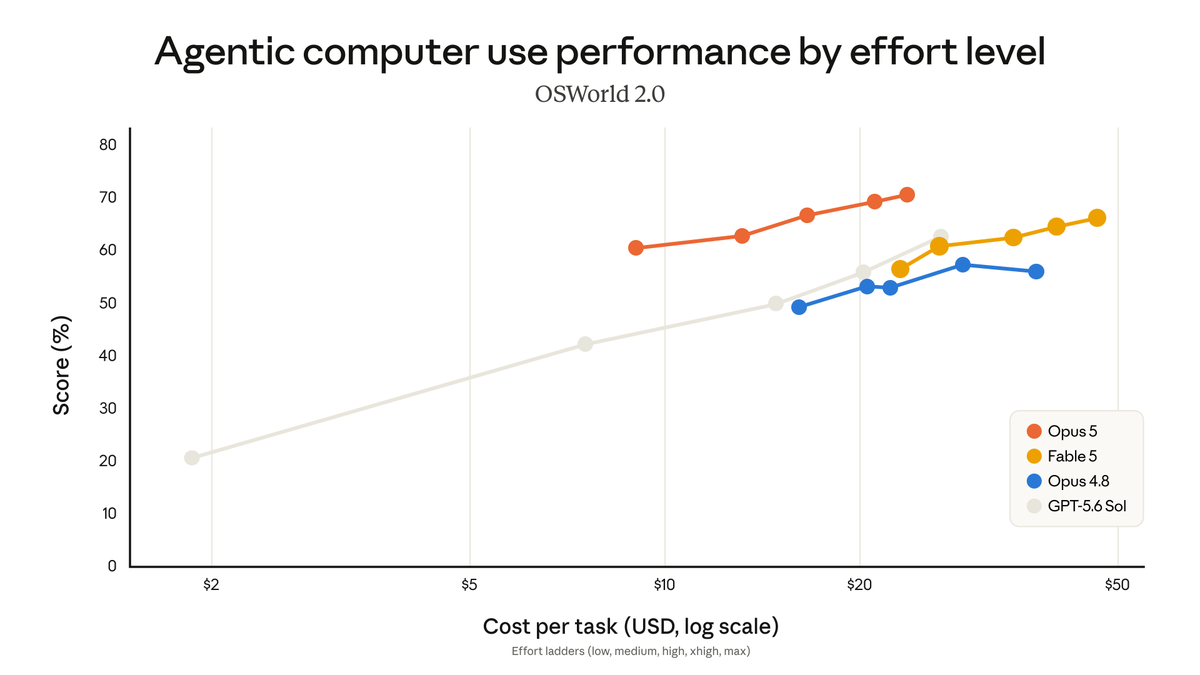
Jul 24, 2026, 04:59 PM·1.4M Views
Claude
Claude
@claudeai
在多项编码和知识工作评估中,Opus 5 是最先进的:
Jul 24, 2026, 04:59 PM·5.6M Views
Claude
Claude
@claudeai
介绍克劳德作品 5。 这是一个深思熟虑且积极主动的模型,以一半的价格接近《神鬼寓言 5》的前沿智能。
Jul 24, 2026, 04:59 PM·23.3M Views
6.1万点赞7528转发3348回复5207引用6606收藏2332.2万浏览在 X 上查看 ↗
2
138.1万
精华分
6 层引用链锐评超原推

回应Steinberger质疑:同一标准harness对所有厂商一致,公平比“给自家模型开挂”更重要

Greg Kamradt
Greg Kamradt
@GregKamradt
我们对 Anthropic/Opus 使用相同的标准线束 相同的完成样式端点 - 没有传回推理日志 重点是各个提供商之间保持一致
Jul 30, 2026, 03:51 AM·20.4K Views
Peter Steinberger 🦞
Peter Steinberger 🦞
@steipete
哈哈,在发布“胜利”推文之前,Anthropic 没有人停下来想知道为什么这些数字看起来如此荒谬? https://openai.com/index/how-two-settings-tripled-our-arc-agi-3-scores/
Jul 30, 2026, 12:00 AM·988K Views
Claude
Claude
@claudeai
在 ARC-AGI-3(人工智能模型必须解决新问题的评估)中,Opus 5 的得分是次优模型的三倍。
Jul 24, 2026, 04:59 PM·2.4M Views
Claude
Claude
@claudeai
Opus 5 也非常高效。它在每项任务成本相似或更低的情况下优于其他模型:
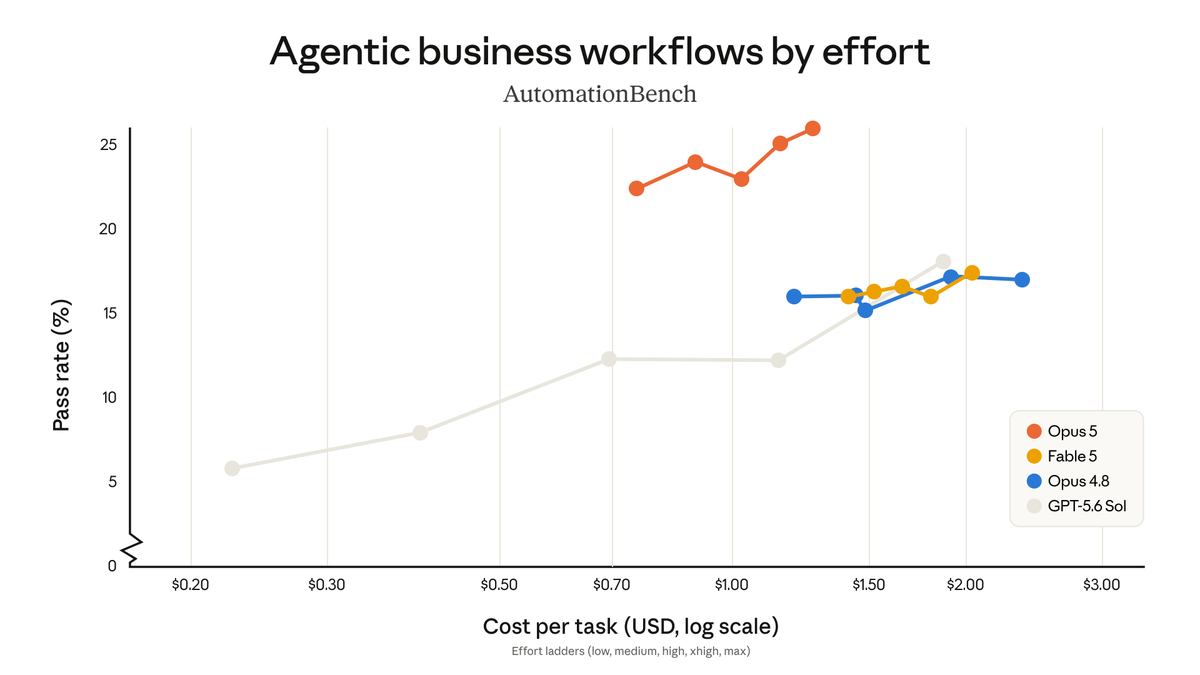
Jul 24, 2026, 04:59 PM·1.4M Views
Claude
Claude
@claudeai
在多项编码和知识工作评估中,Opus 5 是最先进的:
Jul 24, 2026, 04:59 PM·5.6M Views
Claude
Claude
@claudeai
介绍克劳德作品 5。 这是一个深思熟虑且积极主动的模型,以一半的价格接近《神鬼寓言 5》的前沿智能。
Jul 24, 2026, 04:59 PM·23.3M Views
6.1万点赞7528转发3347回复5207引用6606收藏2332.1万浏览在 X 上查看 ↗
3
129.3万
精华分
5 层引用链锐评超原推

引用Claude的ARC-AGI“三倍领先”官宣,用OpenAI实测反将一军:离谱分数更像评测配置问题

Peter Steinberger 🦞
Peter Steinberger 🦞
@steipete
哈哈,在发布“胜利”推文之前,Anthropic 没有人停下来想知道为什么这些数字看起来如此荒谬? https://openai.com/index/how-two-settings-tripled-our-arc-agi-3-scores/
Jul 30, 2026, 12:00 AM·985.4K Views
Claude
Claude
@claudeai
在 ARC-AGI-3(人工智能模型必须解决新问题的评估)中,Opus 5 的得分是次优模型的三倍。
Jul 24, 2026, 04:59 PM·2.4M Views
Claude
Claude
@claudeai
Opus 5 也非常高效。它在每项任务成本相似或更低的情况下优于其他模型:
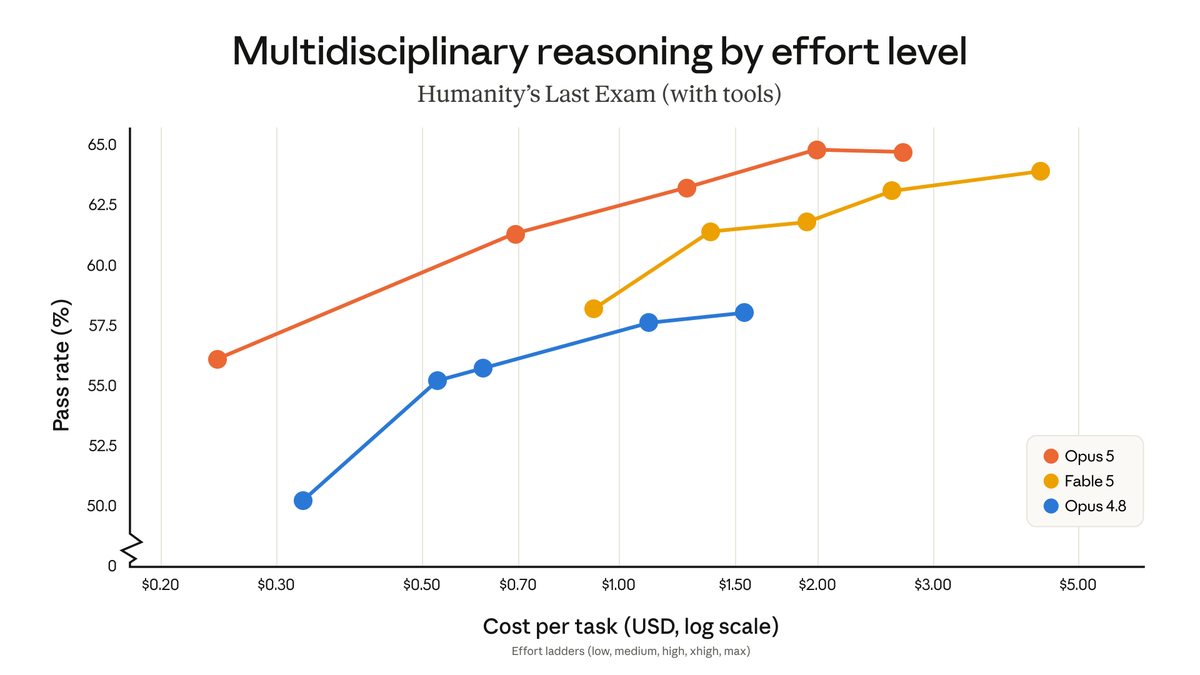
Jul 24, 2026, 04:59 PM·1.4M Views
Claude
Claude
@claudeai
在多项编码和知识工作评估中,Opus 5 是最先进的:
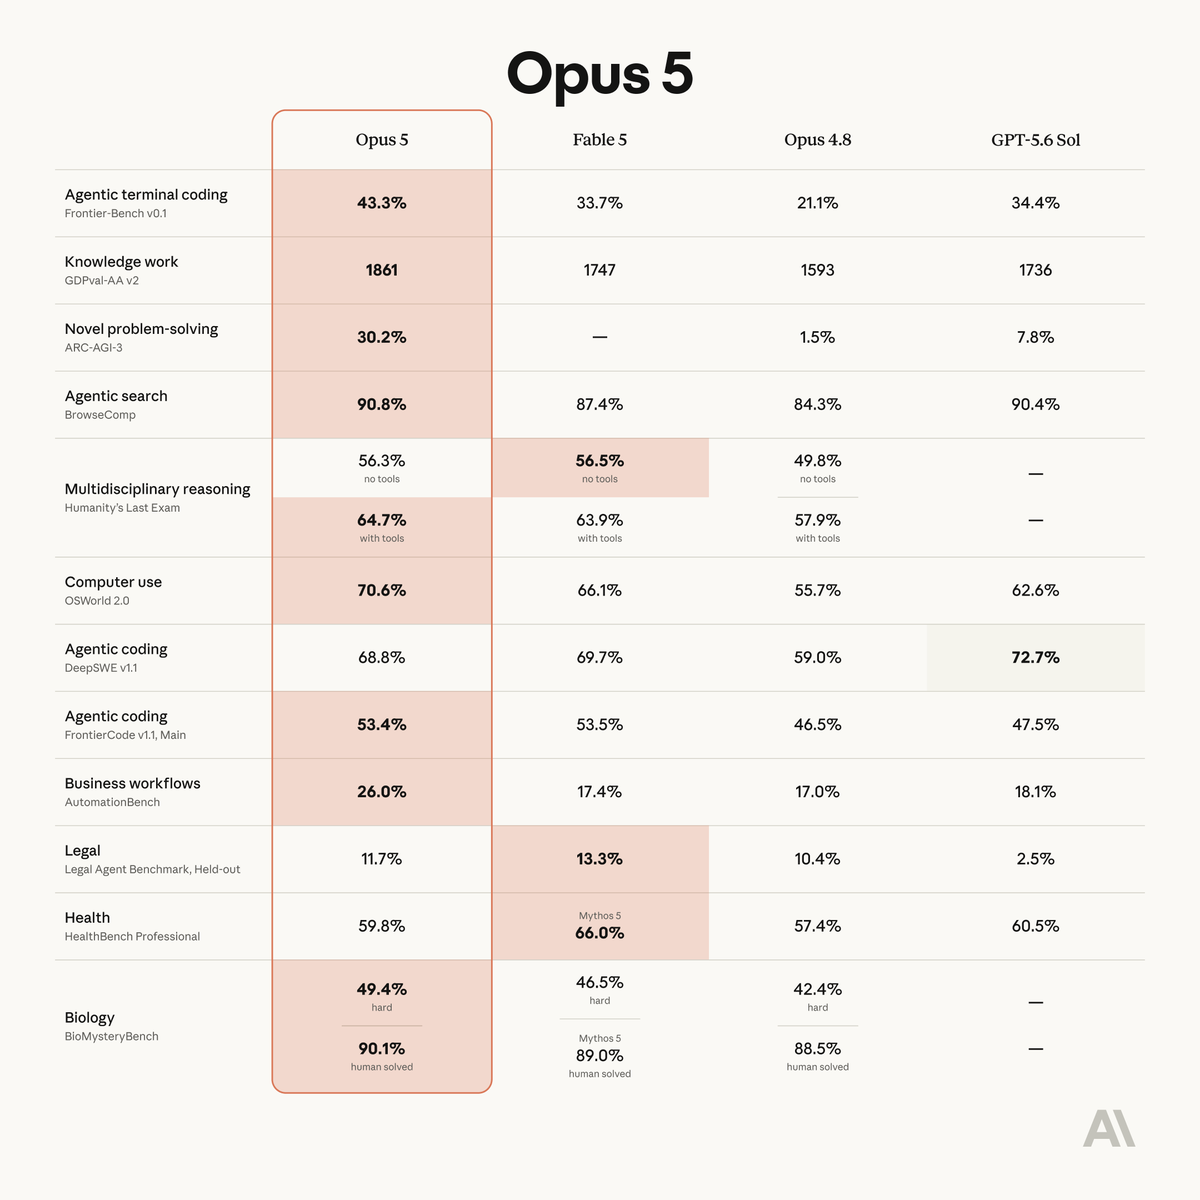
Jul 24, 2026, 04:59 PM·5.6M Views
Claude
Claude
@claudeai
介绍克劳德作品 5。 这是一个深思熟虑且积极主动的模型,以一半的价格接近《神鬼寓言 5》的前沿智能。
Jul 24, 2026, 04:59 PM·23.3M Views
6.1万点赞7527转发3347回复5207引用6606收藏2332.1万浏览在 X 上查看 ↗
4
80.9万
精华分
4 层引用链锐评超原推

接续自家价格战讨论,用CNBC/ARR数据拆解OpenAI营收追赶Anthropic的两种读法

qinbafrank
qinbafrank
@qinbafrank
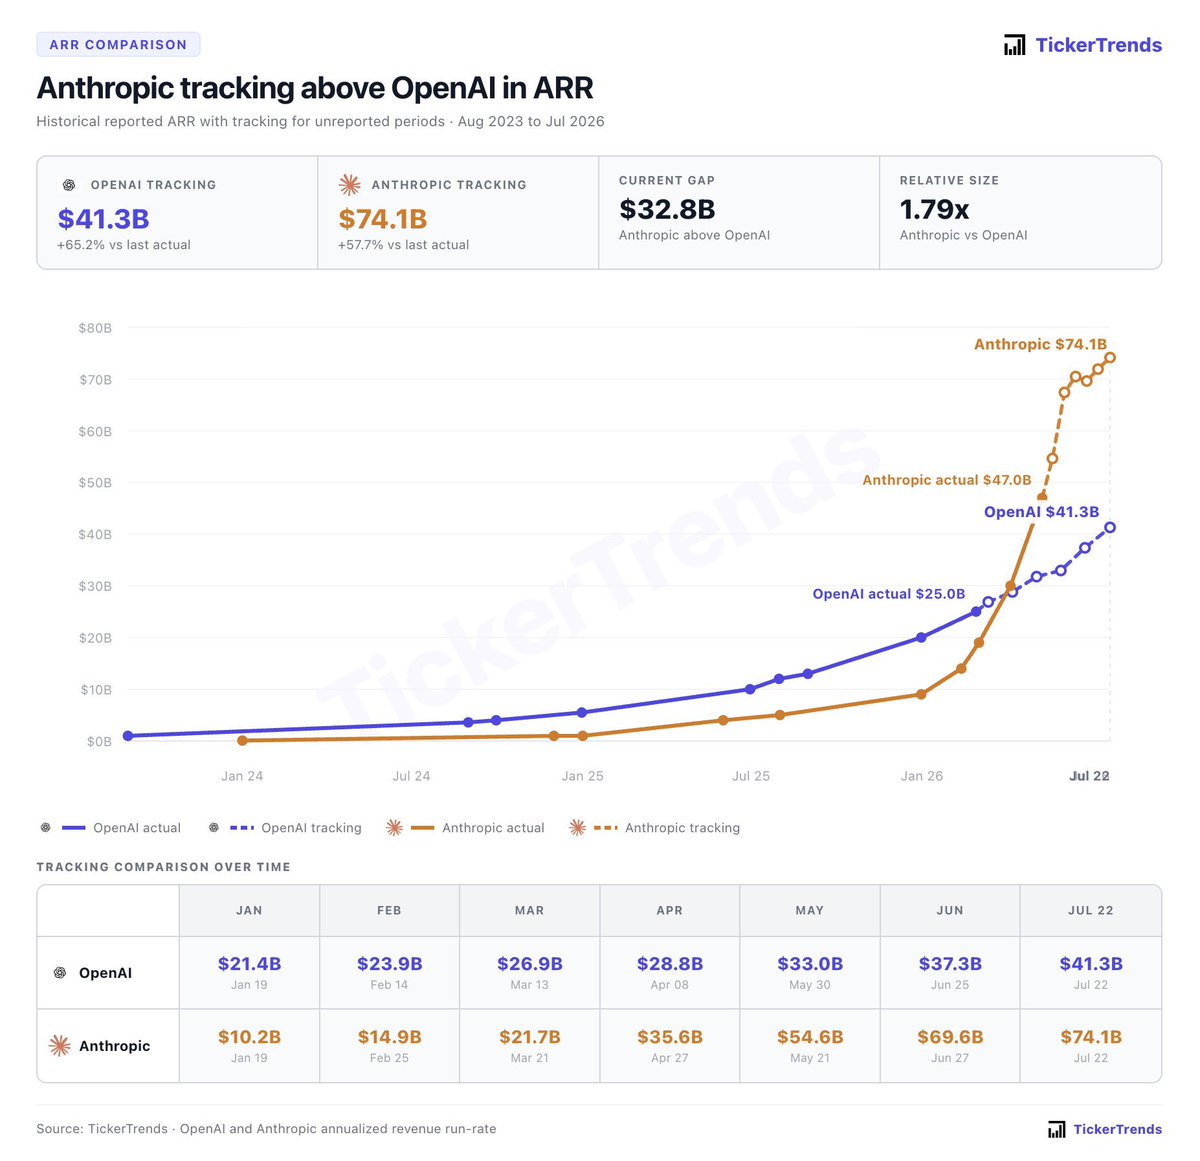
OpenAI的ARR正在大幅度缩小与Authropic的差距,这应该是今天最值得关注的新闻。看CNBC的报道OpenAI首席财务官SarahFriar在周三Openai内部员工会上明确表示,7月的年化经常性收入(ARR)已超过整个第二季度(Q2)的总额。应该怎么理解? 1、看TickerTrenda的数据,整个二季度OpenAI的ARR:4月底是288亿美金、5月底是330亿美、6月底是373亿美金。 整个二季度arr的增量114亿美金。 对应到单月营收(按arr/12来计算) 4月是24亿美金、5月是27.5亿美金,6月是31亿美金。四五六三个月累计是82.5亿美金。 2、OpenAI CFO说7月净新增 ARR 收入规模,超过整个二季度的新增总和(同口径对比,都是净增额)。那就有两种解释: 1)第一种理解:7月净新增 ARR 收入规模,超过整个二季度的新增总和(同口径对比,都是净增额)。 OpenAI 二季度ARR合计新增约 114亿,openAi在7月的arr已经大幅调涨到500多亿美金,正在快速追赶Authropic。 2)第二种理解: 7月单月营收超过二季度三个月营收之和,上面算过二季度四五六三个月单月营收之和是82.5亿美金,那就意味着7月单月营收超过了82.5亿美金、年化ARR已经超过1000亿美金,这有点不敢想了。 保守点按第一种来算,那也意味着正在大幅度缩小与authropic的营收差距。 3、快速增长的原因则来自于 1)GPT-5.6系列模型发布。 2)新企业代理产品ChatGPT Work。 3)AI编码工具Codex的采用持续增长。之前这里https://x.com/thsottiaux/status/2079609157934886975?s=46&t=k6rimWsEbo2D2tXolYcM-A也披露了codex和work的用户在7月大幅度表飙升。
Jul 30, 2026, 03:27 AM·25.8K Views
qinbafrank
qinbafrank
@qinbafrank
一周前聊到的大模型价格战是真的来了,今天几家 AI 大模型公司不约而同做了同一件事: 1)Anthropic 宣布重置所有用户的 5 小时和每周使用限制; 2)OpenAI 再次提高 Codex 和 ChatGPT Work 的使用额度。注意“再次”两个字,说明不是第一次放开限制,而是近期连续多轮上调; 3)xAI 不仅重置了 Grok 的使用限额,还开放了 Grok Build; 4)Cursor更直接,将所有订阅计划的模型使用额度翻倍。 看到这类动作,大家最关心两个问题:为什么要这么做?影响是什么? 1、先说为什么要这么做? 核心还是这两周一起聊到的https://x.com/qinbafrank/status/2076839550119444702?s=46&t=k6rimWsEbo2D2tXolYcM-A 企业采用AI进入分场景、多模型的工程化阶段,企业自己也需要把高频、低复杂度和低价值场景分配给高性价比token、这也倒逼了解前沿闭源大模型主动应战,价格战永远是最有效的策略。 2、再说有何影响? 1)短期来看,大家担心是不是影响大模型的利润率。毕竟价格下降意味着单次调用收入降低,单位 Token 的商业价值下降,短期毛利率和盈利能力自然会承压。 2)但中长期,则是要看能激发出多大的幅度的需求量增长。如果需求爆发式增长、token的消耗量增长幅度大大抵消token单价的降低,最后总盘子变大了。上周在这里https://x.com/qinbafrank/status/2074061695438483754?s=46&t=k6rimWsEbo2D2tXolYcM-A也有聊过:“越多企业采用AI,成本工程化做的越好,高端模型的份额被部分蚕食,但会不会带动商业化份额绝对值应该还是在快速增长?因为盘子更大了。” 但这里最关键的就是这个短期和中长期之间的时间差有多大。降价毛利和盈利能力会立马下去,需求的爆炸是不是能立马补上来,还是需要一点时间才行?
Jul 16, 2026, 03:16 PM·127.5K Views
qinbafrank
qinbafrank
@qinbafrank
可以说这次GPT5.6的发布正式拉开了前沿闭源大模型价格战的序幕?为什么这么说。 先看看GPT5.6的定价结构(API 每百万 tokens,短上下文标准价): 1)Sol(旗舰):$5 输入 / $30 输出(与 GPT-5.5 旗舰价格持平)。 2)Terra:$2.50 / $15(性能接近 GPT-5.5,但成本更低)。 3)Luna:$1 / $6(最便宜,性能仍很强,接近或超过部分前代旗舰)。 这算是OpenAI首次在旗舰系列中推出明确的多层定价,让用户根据任务复杂度灵活选择。Luna和Terra提供了“接近旗舰性能但大幅降低成本”的选项,这对开发者、API 重度用户极具吸引力,直接冲击竞争对手(如 Anthropic 的 Claude 系列)。 此前已有报道称 OpenAI 考虑大幅降价以应对 Anthropic 等竞争,此次通过 tiered 模型实现了“更多能力同价 + 低成本高性能选项”,实质是回应了市场对成本敏感度的需求。 同时推出 prompt caching 新机制(缓存写入 1.25x 等)和多代理功能,进一步提升实际使用性价比。 当然也不算传统“价格战”,因为顶级旗舰Sol价格并未下降,而是“同价更强”。 这更像是价值战和差异化竞争的体现:OpenAI 用分层模型 + Agentic能力(多代理、Work agent)来抢占市场,而非单纯拼低价。更准确地说是“性价比战 / tiered 定价竞争”的加速,而非单纯的旗舰降价大战。 行业整体趋势是类似的——各家(Anthropic、Google、xAI 等)都在优化定价结构、推出tier模型和Agent功能。OpenAI 此举很可能加速这一进程,尤其对闭源前沿模型的 API 定价和 agent 能力竞争。 这标志着顶级闭源大模型从“单一旗舰高价”向多层模型性价比竞争 + agentic功能战”的转变。价格敏感用户会明显受益,行业竞争会更激烈,但短期内旗舰模型大幅跳水式降价可能还不会出现。 长期看,这对整个生态(尤其是开发者)是利好,推动模型更快迭代和更广泛应用。 本条由@bitget_zh赞助,「Bitget 买美股:秒级入场,丝滑交易 」
Jul 10, 2026, 02:01 AM·89.1K Views
OpenAI
OpenAI
@OpenAI
隆重推出 ChatGPT Work,这是由 Codex 和 GPT-5.6 提供支持的 ChatGPT 中的新代理。 它可以对您的应用程序和文件采取行动,如果需要,可以在项目上停留数小时,并将目标转化为完成的工作。 这是一种全新的完成工作的方式。
Jul 9, 2026, 05:41 PM·16M Views
2.2万点赞2259转发1304回复998引用5823收藏1596.3万浏览在 X 上查看 ↗
5
13.3万
精华分
2 层引用链锐评超原推

引用Anthropic密码学弱点研究,补齐HAWK/AES影响与“攻防都要用AI”的加密含义

うみゆき@AI研究
うみゆき@AI研究
@umiyuki_ai
Anthropic 还有一个关于人工智能威胁的危险故事。一个关于 Mythos 发现加密算法弱点的故事。这并不是说特定密码的实现存在错误,而是发现了一个陷阱,使算法本身有些脆弱。如果这个弱点被利用,HAWK的抗量子电子签名的加密强度将从150位下降到108位,这是一个痛苦的过程。 AES据说还可以将攻击速度提高200到800倍,但由于攻击原本需要无限长的时间,所以速度提高800倍似乎也没什么好处。如今,人工智能可以解决未解决的数学问题,甚至可以找到数学算法的弱点。如果这是一个更严重的弱点,而且发现它的不是人类,而是怀有恶意的人,该怎么办?是否可以通过破坏密码学来窃取任意数量的加密货币?当然,防御者也必须使用人工智能在敌人之前发现并解决问题。
Jul 30, 2026, 02:15 AM·19.2K Views
Anthropic
Anthropic
@AnthropicAI
新人类研究:与克劳德一起发现密码学弱点。 Claude Mythos Preview 帮助我们的研究人员发现了加密算法(用于保护数据隐私的数学方法)的弱点。 了解更多:https://anthropic.com/research/discovering-cryptographic-weaknesses
Jul 28, 2026, 05:16 PM·2.5M Views
6034点赞800转发407回复438引用2340收藏249.1万浏览在 X 上查看 ↗
6
4.2万
精华分
2 层引用链锐评超原推

回复Polymarket“Yahoo要10年Claude Code经验”:对等嘲讽招聘JD像ChatGPT写的

Fugitive Sloth
Fugitive Sloth
@FugitiveSloth
@Polymarket 这份职位描述是由拥有 15 年 ChatGPT 经验的人撰写的
Jul 30, 2026, 01:10 AM·12.1K Views
Polymarket
Polymarket
@Polymarket
最新消息:雅虎新招聘的高级软件开发人员需要 10 年以上的 Claude Code 经验。
Jul 30, 2026, 01:07 AM·677.9K Views
7689点赞412转发306回复211引用474收藏67.8万浏览在 X 上查看 ↗
7
3.7万
精华分
4 层引用链锐评超原推

引用OpenAI harness工程细节,点破低垂果实:评测/推理侧配置就能大幅改成本与分数

Nathan Lambert
Nathan Lambert
@natolambert
线束工程上唾手可得的成果是疯狂的。 最重要的是,科学/工程领域有一个有趣的领域,即如何最好地研究安全带的效果,从后期培训到评估/推理。将是一个相当有影响力的领域(在每场演出的成本节省方面)
Jul 30, 2026, 03:18 AM·23.2K Views
OpenAI
OpenAI
@OpenAI
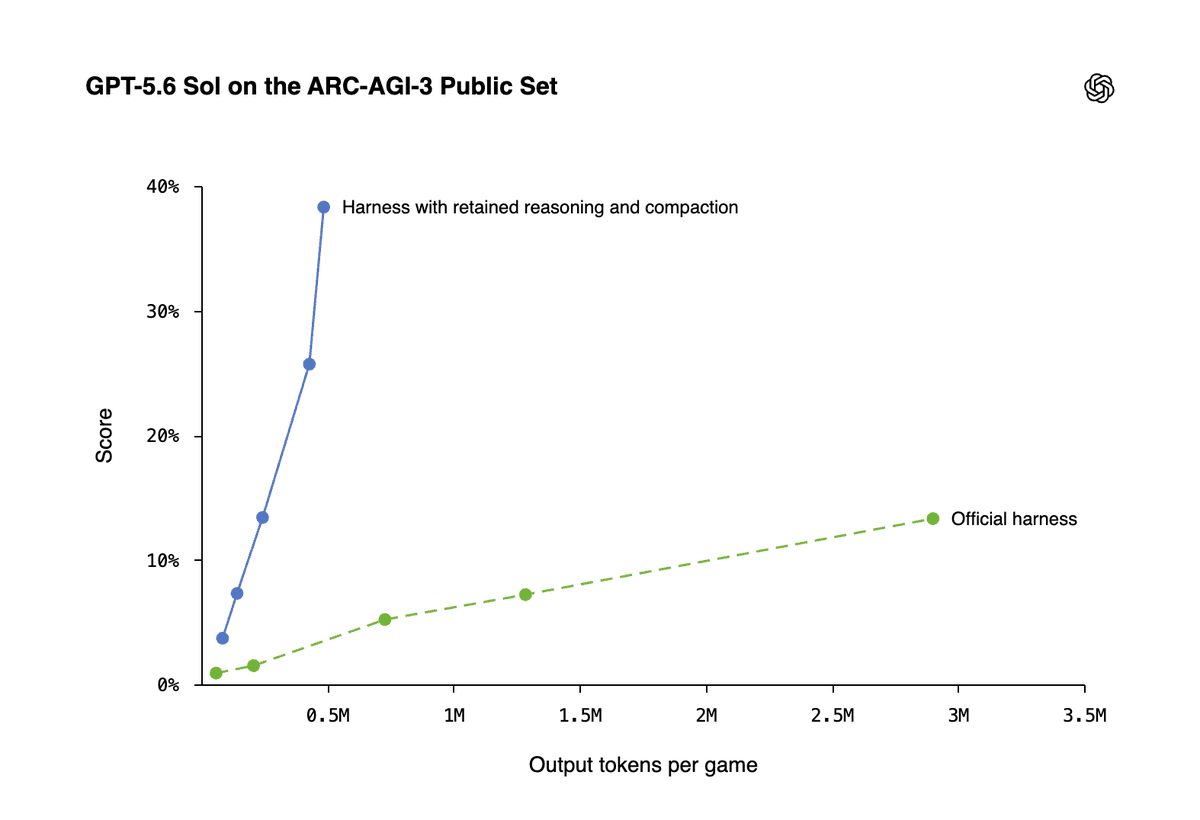
我们使用 Responses API 实现了该工具并打开: → 保留推理 → 上下文压缩 在公共集上,GPT-5.6 Sol 的分数上升了 188%,同时使用的输出代币减少了 6 倍。
Jul 29, 2026, 11:57 PM·71.2K Views
OpenAI
OpenAI
@OpenAI
ARC-AGI-3 测试模型在没有指令的情况下学习不熟悉的 2D 游戏的能力。 标准工具在每次移动后都会放弃 GPT-5.6 Sol 的推理,并在上下文填满时放弃之前的操作。该模型必须重新开始。
Jul 29, 2026, 11:57 PM·50.4K Views
OpenAI
OpenAI
@OpenAI
GPT-5.6 Sol 已用于解决数学中的开放问题。那么,为什么它在 2D 益智游戏标杆 ARC-AGI-3 上举步维艰呢? 我们调查了。安全带并没有让它记住所学到的东西。 我们发现,启用两种 API 设置后,我们的分数增加了两倍,而输出标记减少了 6 倍。
Jul 29, 2026, 11:57 PM·416.1K Views
5399点赞337转发230回复115引用956收藏41.6万浏览在 X 上查看 ↗
8
3.2万
精华分
2 层引用链锐评超原推

官方引用OpenAI harness说明:肯定结果有用,同时解释“无harness”对照为何必须公平

ARC Prize
ARC Prize
@arcprize
OpenAI 的内部测试表明,提供商管理的对话状态可以保持更大的跨轮连续性,并提高 ARC-AGI-3 等长期任务的性能。这是一个真实且有用的结果。我们很高兴看到 ARC 用于识别有用的线束设计。 ARC 的验证分数使用“无控制”方法来避免意外或故意的开发人员意识目标,并公平地比较所有提供商的分数。所有系统都会收到相同的观察结果、系统提示,并在相同的操作限制下运行。会话状态是使用 LLM 的行业标准接口(OpenAI 风格的完成 API)在客户端进行管理的。 我们希望 ARC 的进展能够反映真正的 AGI 进展,而不是 ARC 特定的格式培训或设置,并且我们正在积极与包括 OpenAI 在内的多个行业实验室合作,以找出如何最好地将这些服务器端状态管理结果纳入我们经过验证的测试设置,同时在提供商之间保持公平和一致。
Jul 30, 2026, 03:37 AM·24.1K Views
OpenAI
OpenAI
@OpenAI
GPT-5.6 Sol 已用于解决数学中的开放问题。那么,为什么它在 2D 益智游戏标杆 ARC-AGI-3 上举步维艰呢? 我们调查了。安全带并没有让它记住所学到的东西。 我们发现,启用两种 API 设置后,我们的分数增加了两倍,而输出标记减少了 6 倍。
Jul 29, 2026, 11:57 PM·415.6K Views
5392点赞337转发230回复115引用956收藏41.6万浏览在 X 上查看 ↗
9
6984
精华分
2 层引用链锐评超原推

引用a16z Casado的三派harness犹豫,给出可操作二分:可被模型吸收的通用层 vs 不可约的任务末一公里

Omar Khattab
Omar Khattab
@lateinteraction
在我看来,答案看似简单。 有一个通用用途工具的概念(例如,CoT 推理、适当压缩或 RLM),本质上正是“模型”应该成为的样子。 API 中更好的“模型”最终将对其进行包装并进行相应的训练。 还有一个单独的安全带概念,它是基础平淡模型的最后一英里规范。如果您的任务/上下文与模式不同,无论能力如何,这都是不可简化的。在这里,复杂性越接近所需的最小位数越好。
Jul 30, 2026, 04:47 AM·6.6K Views
martin_casado
martin_casado
@martin_casado
关于安全带,我在三个信念之间摇摆不定: - 安全带越少越好。模型就是魔法 - 训练后模型和线束明显更好,模型提供者获胜 - 线束具有真正独立于模型的价值 我不知道哪个是对的。
Jul 29, 2026, 06:03 PM·90.8K Views
605点赞19转发166回复30引用247收藏9.1万浏览在 X 上查看 ↗
10
6314
精华分
2 层引用链锐评超原推

引用自己6月做空美光长文复盘:资金/情绪/预期三顶判断被行情打脸式验证

电鱼哥专注SpaceX
电鱼哥专注SpaceX
@iiiinvest
回头看1200做空美光这篇,知行合一,简直神一般的存在!
Jul 30, 2026, 03:33 AM·14.9K Views
电鱼哥专注SpaceX
电鱼哥专注SpaceX
@iiiinvest
旗帜鲜明,为什么做空1200的美光? 1、资金面到顶了,昨天美光单日成交额1000亿美金,要知道SpaceX上市才800亿,也就是所有投机资金该买的都买了,从哪里找很多资金去承接这1000亿? 2、情绪面到顶了,昨天财报发布,不是利好而是超超超利好,随着股价拉升都是牛逼之声,加之当前存储之热,情绪面没有敢看空的。 3、预期拉满了,售价订单财报解读都是透支未来几年,股价从来不是交易现在,而是交易的未来,任何风吹草动都是瀑布。 短期强烈看空,知行合一,夜盘先上第一枪,开盘继续加仓空!
Jun 26, 2026, 04:38 AM·138.1K Views
167点赞10转发57回复2引用55收藏13.8万浏览在 X 上查看 ↗